从一千行里找出十行:把问题拆成一条管道
沿一份实验日志,先筛错误,再取模块、合并计数、留下摘要。每接一段,都看清它收到了什么、交出了什么。
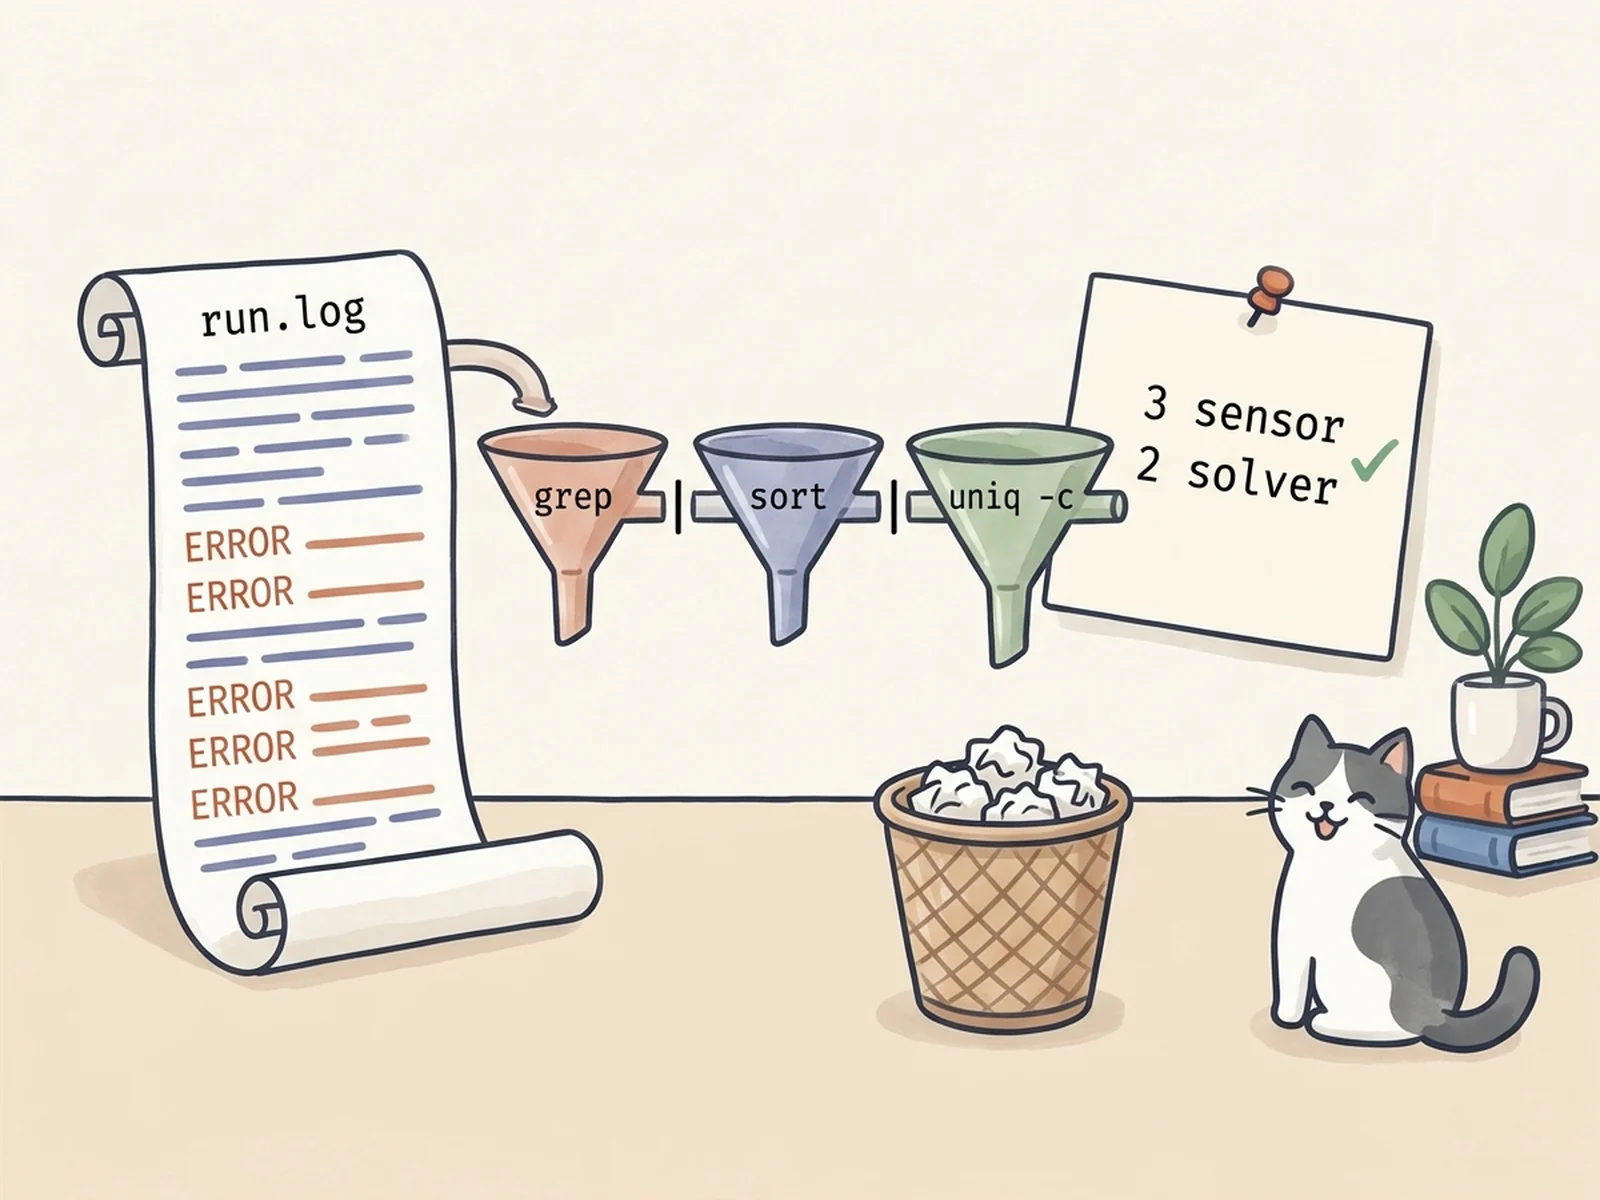
一次实验跑完,你拿到一大份日志。里面有启动消息、提醒,也有错误。你现在只想回答一件事:哪个模块留下的错误记录最多?
直接搜 ERROR,能把范围缩小,却还不能回答“哪个最多”。我们就从这一步开始,每次只让一个工具接走一件事。
先确认留下的确实是错误
一条日志长这样:
2026-10-01 09:00:01 ERROR sensor timeout当前要保留的,是级别为 ERROR 的完整记录。先做字面检索:
grep -F ' ERROR ' run.log-F 让 grep 把条件按固定字符串理解,避免把符号当成正则语法。两侧的空格也属于条件,帮助我们与行里的其他文字区分开。
输出里应有六条记录,原来的日期、时间和消息都还在。这一步先读几行,检查你留下的是哪类内容,然后才值得往后计数。
grep ... | wc -l 可以数匹配行,但这里问的是模块出现的次数。六条错误记录,不等于六个模块。
只取能回答问题的那一列
把刚才那行分开看:
第 1 列      第 2 列    第 3 列   第 4 列   后面的消息
2026-10-01 09:00:01 ERROR sensor timeout现在只需要第四列。cut 可以按指定分隔符取字段:
grep -F ' ERROR ' run.log | cut -d ' ' -f 4-d ' ' 指定一个空格作为分隔符,-f 4 取第四个字段。grep 交出来的每条错误记录,经过 cut 后只剩一个模块名。
你应当看到:
sensor
solver
sensor
mesh
solver
sensor
仍是六行。每一行现在代表“一条错误记录所属的模块”,不再代表整条日志。
重复的名字,为什么没有合到一起
现在想计数。uniq -c 会把相邻重复行合并,并在前面打印次数。直接接上试试:
grep -F ' ERROR ' run.log | cut -d ' ' -f 4 | uniq -c结果却还是六项,每项都是 1。三个 sensor 被别的模块隔开了,uniq 没有把它们当成同一组。
到这里,才需要 sort:先让相同名字排到一起。
grep -F ' ERROR ' run.log | cut -d ' ' -f 4 | sort | uniq -c现在得到三项:
      1 mesh
      3 sensor
2 solver先做一个小核对:1 + 3 + 2 = 6,与第一步筛出的错误行数一致。模块数是三,错误记录数是六,两个数字各有自己的分母。
排序改变了出现顺序。为了回答“哪个最多”,我们接受这次变化;如果要追查“第一次错误前后发生了什么”,应该回到带时间的原始记录,而不是从这张计数表恢复过程。
次数最多的两项,留下就够了
上一段已经有次数,但默认 sort 排的是文字。现在让它按行首的数字排:-n 用数值比较,-r 反向排列。
再交给 head -n 2,只取前两项:
grep -F ' ERROR ' run.log | cut -d ' ' -f 4 | sort | uniq -c | sort -nr | head -n 2应当留下 sensor 三次、solver 两次。确认内容以后,在末尾接上 > summary.txt,保存这次摘要。
加入三条 mesh 错误以后,新的计数是 mesh 四次、sensor 三次、solver 两次。summary.txt 会自动更新吗?
这也是整条管道值得保存的原因:你留下的既是一份结果,也是一套能从当前输入重新生成结果的办法。保存结果文件时仍要确认名称,> 会覆盖已有内容。
如果次数相同,谁排在前面?
sort -nr 还可能按整行文字打破数值相同的并列;字符排序与 locale 设置有关。本篇的前两项没有并列,因此不依赖这个细节。
真实任务如果规定并列时按名称、时间或其他字段排序,需要显式写出规则。如果目标是比较不同机器的精确输出,也应统一 locale。先决定问题的含义,再决定排序方式。
把每一段的账留下来
现在回头看,你已经完成五次小变换:
| 这一段 | 收到什么 | 交出什么 |
|---|---|---|
grep -F ' ERROR ' | 完整日志 | 六条错误记录 |
cut -d ' ' -f 4 | 六条错误记录 | 六个模块名 |
sort → uniq -c | 重复且交错的名字 | 每个模块一条计数 |
sort -nr | 三项计数 | 次数从多到少的名单 |
head -n 2 | 排好序的名单 | 前两项摘要 |
不需要一口气写出整条命令。先让第一段说对,再接下一段。 出现异常时,把后面的管道暂时拿掉,找到第一次不符合预期的中间结果。
也要留意上一课的失败:来源不存在时,后面的工具可能仍正常产生空结果。pipefail 能暴露部分失败,但非零不一定都是故障,例如 grep 没选出匹配行也会返回 1。
带走日志,在自己的终端重做
下载本篇的十二行练习日志,放到一个新的练习目录里。在 Bash 中进入那个目录,先用 cat run.log 确认读到的是这份文件。
合上前面的完整命令,重新做一份 summary.txt,然后改三个条件:
- 不限制前两项,保留所有模块计数。三项次数相加应是六。
- 只看 WARN 记录。原始日志里有一条,所属模块是 mesh。
- 在日志末尾加一条 sensor 的 ERROR 记录,重跑摘要。sensor 应变成四次;摘要没有重跑时仍是旧版本。
最后解释一句:“sensor 的错误记录最多”,能不能推出“sensor 一定是故障根源”?
练习使用固定格式的教学数据;管道卡片展示模型中每一段完成后的文本,不代表真实管道按卡片顺序逐个启动。本模型不模拟并发或大型数据的性能。工具细节可读 Coreutils 的 sort、uniq 与 cut 说明;其中 uniq 只合并相邻重复行是这一篇最需要记住的条件。技术说明核验于 2026-10-02。
这次留下的是日志的摘要。想同时留下整理过程的修改历史,可以接着做渐进式 Git里的第一张快照。
如果接下来运行的程序迟迟不交回提示符,继续看进程与任务。先把“它还在不在运行”看清,再去讨论后台操作。